


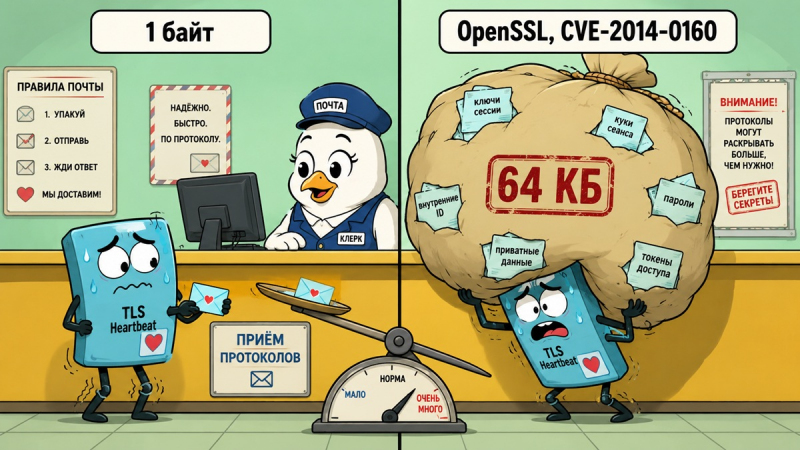
Почти 70% уязвимостей, ежегодно регистрируемых Microsoft под номерами CVE, возникают из-за проблем с управлением памятью. В проекте Chromium ситуация аналогична: около 70% критических багов в Chrome связаны с небезопасными операциями с памятью, из которых половина приходится на обращения к уже освобожденным участкам. Несмотря на десятилетия работы с C и C++, индустрия продолжает натыкаться на одни и те же грабли, которые теперь встроены в браузеры, серверное ПО и обновления микропрограмм.
C++ — не случайно сложный язык. Он сознательно позволяет работать на низком уровне с памятью, пропускать обязательные проверки и выжимать производительность там, где лишний контроль действительно стоит денег. Но такая свобода требует дисциплины: объект должен существовать дольше ссылки на него, индекс не должен выходить за допустимые границы, размер буфера нельзя вычислять по принципу «авось сработает», а два потока не должны одновременно изменять одну переменную.
При нарушении этих правил программа часто не завершается немедленно. Она может пройти тесты, неделю работать на сервере и сломаться после очередной оптимизации, получения некорректного файла или специально сформированного сетевого пакета. Разработчик утверждает: «У нас всё работало». Оператор изучает дамп процесса. Злоумышленник, если ему повезло больше, чем команде, получает доступ раньше всех.
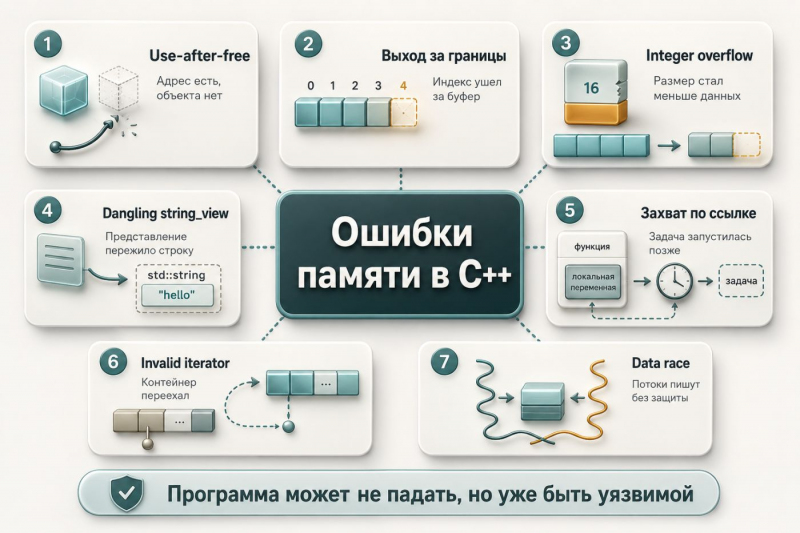
Неопределённое поведение: программа перестаёт давать гарантии
Undefined behavior (UB) в русском переводе означает «неопределённое поведение». Согласно стандарту, при возникновении UB язык не гарантирует никакого конкретного результата выполнения программы. Компилятор не обязан предупреждать о проблеме. Процесс не обязан завершаться с ошибкой. Код может вывести ожидаемое значение, произвольные данные, конфиденциальную информацию или выполнить совершенно другую логику после оптимизации.
Причина проста: оптимизатор рассуждает только о корректных программах. Если стандарт запрещает переполнение знаковых чисел, компилятор вправе считать, что переполнения никогда не происходит. Проверка, основанная на попытке обнаружить уже случившееся переполнение, может быть исключена из исполняемого кода.
#include bool grows_after_increment(int value) { return value + 1 > value; // При value == INT_MAX выражение value + 1 вызывает UB. // Оптимизатор вправе упростить функцию до return true;}bool can_increment(int value) { return value < std::numeric_limits::max();} Компилятор здесь не ведёт себя агрессивно и не «ломает обычную арифметику». Разработчик сначала пообещал соблюдать правила языка, а затем попытался построить логику на их нарушении. В C++ такие трюки редко выглядят подозрительно в исходном коде, зато отлично смотрятся в отчёте о взломе.
Использование после освобождения: указатель есть, а объекта нет
Память и объект в C++ — не одно и то же. Программа может освободить участок памяти, сохранив указатель на прежний адрес. Числовое значение указателя остаётся прежним, но объект уже не существует. При следующем выделении этот же участок может быть занят новыми данными.
#include void read_dead_object() { int* value = new int(42); delete value; std::cout << *value; // UB: память больше не содержит объект int} Так возникает использование после освобождения, известное как CWE-416. Пока освобождённый блок не занят новыми данными, программа иногда выводит старые значения, создавая иллюзию работы. Если же блок переиспользован, старый указатель начинает читать или изменять чужое состояние. В удачном для злоумышленника сценарии такой дефект превращается в подмену объекта, повреждение структур данных или выполнение произвольного кода.
Похожая проблема возникает при повторном освобождении одного блока. Менеджер памяти получает два запроса на освобождение одного участка и может повредить собственные служебные структуры или завершить программу.
void release_twice() { int* value = new int(42); delete value; delete value; // UB: повторное освобождение того же блока}Умный указатель std::unique_ptr значительно снижает риск, поскольку выражает единоличное владение и освобождает память автоматически. Однако утверждение «unique_ptr полностью исключает использование после освобождения» ошибочно. С помощью get() можно получить обычный указатель, сохранить его и использовать после уничтожения владельца.
#include #include void smart_pointer_is_not_a_force_field() { auto owner = std::make_unique(42); int* borrowed = owner.get(); owner.reset(); std::cout << *borrowed; // UB: borrowed пережил владельца} Практическое правило из C++ Core Guidelines звучит строго, но полезно: обычный указатель T* в современном коде следует считать невладеющим. Владение следует выражать через контейнеры, объекты, std::unique_ptr или, если действительно необходимо совместное владение, через std::shared_ptr.
Heartbleed: как лишний параметр длины заставил сервер сливать память
В апреле 2014 года уязвимость Heartbleed в OpenSSL продемонстрировала, насколько дорого может обойтись доверие к размеру, переданному отдельно от данных. Ошибка получила номер CVE-2014-0160. Проблемный код обрабатывал heartbeat-сообщение протокола TLS: клиент отправлял данные и сообщал их длину, а сервер должен был вернуть эти же данные.
Проблема заключалась в том, что OpenSSL не проверял соответствие заявленной длины фактически полученным данным. Злоумышленник мог отправить один байт, указать длину 64 КБ и получить в ответ присланный байт вместе с соседними участками памяти процесса. Официальное уведомление OpenSSL упоминало возможность раскрытия содержимого памяти клиента или сервера.
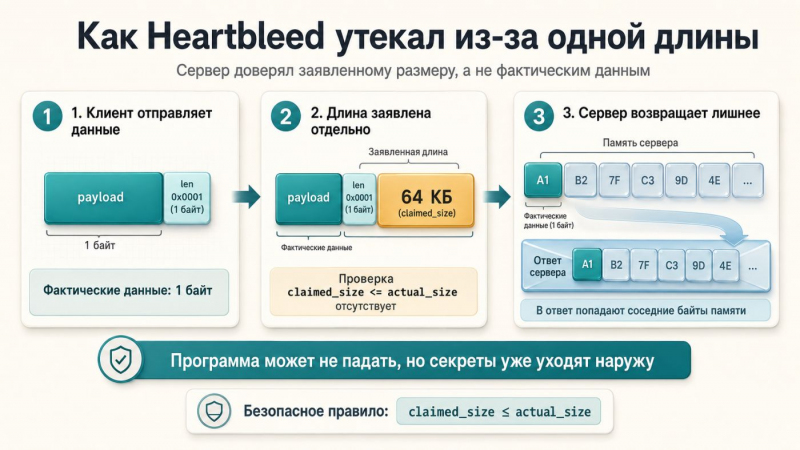
#include #include #include std::unique_ptr broken_heartbeat( const std::byte* payload, std::uint16_t actual_size, std::uint16_t claimed_size){ auto reply = std::make_unique(claimed_size); // Ошибка: claimed_size пришёл от клиента, // но не проверено условие claimed_size <= actual_size. std::memcpy(reply.get(), payload, claimed_size); return reply;} Heartbleed был чтением за границами, а не записью или прямым выполнением кода. Сервер мог продолжать работать. Он просто возвращал соседние байты памяти, где могли находиться сеансовые ключи, пароли и закрытые данные. Этот пример особенно показателен: утверждение «программа не упала» никак не связано с утверждением «программа безопасна».
Выход за границы: один неверный символ и доступ к чужой памяти
Самая распространённая ошибка диапазона выглядит почти безобидно. Разработчик использует <= вместо <, и цикл делает лишнюю итерацию. При чтении программа может раскрыть соседние данные. При записи она изменяет байты за пределами массива: служебные поля, соседние объекты, указатели или защитные значения в стеке.
#include void clear_buffer(unsigned char* data, std::size_t size) { for (std::size_t i = 0; i <= size; ++i) { data[i] = 0; // последняя итерация пишет за границей буфера }} В классическом сценарии переполнение буфера в стеке позволяет перезаписать управляющие данные, включая адрес возврата из функции. Современные системы усложняют эксплуатацию через защиту стека, запрет исполнения данных и рандомизацию памяти, но повреждение данных никуда не исчезает. Защита может превратить удобную уязвимость в аварийное завершение, но серверу от краша под атакой обычно не легче.
Начиная с C++20, std::span позволяет передавать непрерывный диапазон вместе с размером, не разделяя их на отдельные параметры. Однако span — не бронежилет. В C++20 и C++23 у этого представления отсутствует метод at(), а обычный operator[] не обязан проверять индекс. Метод span::at() появился в C++26 после принятия предложения P2821R5.
#include bool set_flag(std::span bytes, std::size_t index) { if (index >= bytes.size()) { return false; } bytes[index] = 1; return true;} Смысл span не в том, что некорректный индекс вдруг становится безопасным. Этот тип делает размер частью интерфейса и упрощает правильные проверки. Если индекс получен из внешнего источника, разработчик всё равно обязан сравнить его с размером.
Переполнение целых чисел: буфер маленький, а копирование большое
Ошибки памяти часто зарождаются ещё до обращения к памяти. Код получает размер входных данных, добавляет длину заголовка, выделяет буфер и копирует данные. Если при вычислении размера происходит переполнение, программа выделяет небольшой блок, а затем записывает в него большой объём информации.
#include #include #include void copy_packet(const std::byte* input, std::uint32_t user_length) { constexpr std::uint32_t header_size = 16; std::uint32_t total = user_length + header_size; // Для беззнаковых чисел переполнение определено как арифметика по модулю. // Огромный user_length может превратить total в небольшое число. auto output = std::make_unique(total); std::memcpy(output.get() + header_size, input, user_length); // Если total «обернулось», запись выйдет за пределы выделенного буфера.} Для беззнаковых типов поведение арифметики определено: значения циклически переполняются. Но предсказуемо неверный размер остаётся уязвимостью. Для знаковых чисел ситуация хуже: выход за пределы диапазона вызывает UB, после чего оптимизатор может удалить проверки, которые рассчитывали обнаружить переполнение постфактум.
Проверку следует выполнять до опасной операции:
#include #include #include #include bool copy_packet_safe( const std::byte* input, std::uint32_t user_length, std::unique_ptr& output){ constexpr std::uint32_t header_size = 16; if (user_length > std::numeric_limits::max() - header_size) { return false; } const std::uint32_t total = user_length + header_size; output = std::make_unique(total); std::memcpy(output.get() + header_size, input, user_length); return true;} В реальном коде к проверке переполнения следует добавить проверку фактически доступного размера входного буфера. Иначе функция корректно выделит память, но прочитает больше данных, чем доступно в источнике.
Висячие представления: string_view не является владельцем строки
std::string_view хранит адрес и длину строки, но не саму строку. Это представление удобно как параметр функции: не нужно копировать строку, если функция только читает существующий текст. Опасность возникает, когда представление переживает строку-владельца.
#include #include class Response {public: explicit Response(std::string body) : body_(std::move(body)) {} std::string_view body() const { return body_; }private: std::string body_;};std::string_view broken_response_body() { Response response("token=secret"); return response.body(); // response уничтожается, возвращённое представление становится недействительным} Прямой возврат адреса локальной переменной современные компиляторы часто обнаруживают. Clang поддерживает предупреждение -Wreturn-stack-address, GCC использует -Wreturn-local-addr. Пример с объектом и его методом ближе к реальной проблеме: в крупном проекте строка и представление могут разойтись через несколько уровней вызовов, и предупреждение уже не гарантирует безопасность.
Если функция создаёт строку, безопаснее вернуть владеющий объект. Современный C++ оптимизирует возврат объектов, а попытка сэкономить на гипотетическом копировании может обернуться реальной проблемой с висячим указателем.
std::string response_body() { return "token=secret";}Лямбды и отложенные вызовы: ссылка не знает, что её задача отложена
Похожая ловушка возникает в многопоточном коде и обработчиках событий. Лямбда захватывает локальную переменную по ссылке, функция ставит задачу в очередь и завершается, а обработчик запускается позже. Ссылка внутри задачи продолжает существовать, но объект, на который она указывала, уже уничтожен.
#include #include void schedule(std::function task);void send_request(const std::string& token);void start_job() { std::string token = "secret"; schedule([&token] { send_request(token); // UB, если задача выполнится после завершения start_job() });} Если заданию нужна собственная копия строки, значение следует захватывать явно. Когда объект крупный и общий, владение следует проектировать отдельно, а не надеяться, что очередь всегда успеет обработать задачу до завершения функции.
void start_job_safe() { std::string token = "secret"; schedule([token = std::move(token)] { send_request(token); // задача владеет собственной строкой });}Проблема асинхронного кода особенно неприятна тем, что в тестовой среде задача часто выполняется быстро, и ошибка не проявляется. Рабочая система под нагрузкой увеличивает временные интервалы, и «никогда не возникавший» дефект проявляется именно тогда, когда журнал уже переполнен вторичными ошибками.
Контейнеры: vector переезжает, unordered_map перестраивается
Стандартные контейнеры избавляют разработчика от ручного управления памятью, но не отменяют проблемы времени жизни ссылок и итераторов. std::vector хранит элементы последовательно. При нехватке ёмкости добавление элемента выделяет новый блок и переносит содержимое. Ссылки, указатели и итераторы на старые элементы после переноса становятся недействительными.
#include #include #include void print_first() { std::vector names{"Alice"}; const std::string& first = names[0]; names.push_back("Bob"); // может переместить элементы в новую память std::cout << first; // UB, если перенос состоялся} Ошибка зависит от размера данных. Пока выделенной памяти хватает, программа работает. Первое перераспределение превращает ссылку в проблему. Метод reserve() полезен, если верхняя граница размера действительно известна, но не является универсальным решением: следующий рефакторинг может добавить элемент сверх обещанной ёмкости.
У других контейнеров действуют иные правила. Вставка в std::map не делает недействительными ссылки и итераторы существующих элементов. Для std::unordered_map вставка может вызвать перестройку хеш-таблицы, после которой итераторы становятся недействительными. Поэтому совет «никогда не храните ссылки на элементы контейнера» слишком общий, а привычка не читать спецификацию конкретного контейнера — слишком дорогая.
RAII и правило нуля: владение должно быть очевидным из типа
RAII связывает ресурс с временем жизни объекта: конструктор получает ресурс, деструктор освобождает. Этот подход предотвращает множество утечек и повторных освобождений, поскольку освобождение происходит автоматически при любом выходе из области видимости, включая исключения и досрочный return.
Однако класс, который хранит сырой указатель-владелец, легко ломается при копировании. Компилятор генерирует копирующие операции, которые копируют значение указателя, а не дублируют ресурс. Два объекта начинают считать себя владельцами одного блока.
#include class BrokenBuffer {public: explicit BrokenBuffer(std::size_t size) : data_(new char[size]) {} ~BrokenBuffer() { delete[] data_; }private: char* data_;};void crash_later() { BrokenBuffer first(1024); BrokenBuffer second = first; // копируется адрес одного буфера} // оба деструктора вызывают delete[] для одного адреса: UB Классическое правило пяти требует вручную определить деструктор, копирующий конструктор, копирующее присваивание, перемещающий конструктор и перемещающее присваивание. Для большинства прикладных классов лучше правило нуля: передать владение стандартному контейнеру или умному указателю, не определяя специальные методы вручную.
#include #include class Buffer {public: explicit Buffer(std::size_t size) : data_(size) {}private: std::vector data_;}; std::shared_ptr не стоит использовать повсеместно как универсальное решение. Совместное владение усложняет понимание времени жизни и допускает циклы, при которых память не освобождается никогда. Когда объект имеет единственного владельца, std::unique_ptr или обычное значение точнее передают намерения.
После std::move: объект остаётся, но его состояние не гарантировано
Распространено неверное понимание std::move. Сам по себе вызов std::move ничего не уничтожает. Для объектов стандартной библиотеки перемещённый объект обычно остаётся корректным, но его конкретное состояние после перемещения не определено стандартом.
#include #include void store_token(std::string token) { std::string stored = std::move(token); if (!token.empty()) { audit(token); // Для std::string чтение допустимо, // но логика ошибочна: token не обязан быть ни пустым, // ни содержать прежнюю строку. } token = "new-token"; // присваивание корректно} Здесь чтение token после перемещения не обязано быть UB. Ошибка логическая: программа строит вывод на предположениях, которые интерфейс больше не гарантирует. Настоящее UB возникает, когда пользовательский тип некорректно реализует перемещение, например оставляет два объекта владельцами одного ресурса, что приводит к двойному освобождению.
Надёжное правило проще тонкостей: после перемещения объект можно уничтожить или присвоить ему новое значение. Любые другие действия должны опираться на явные гарантии конкретного типа, а не на наблюдение, что «в моей сборке строка стала пустой».
Неинициализированные значения и изменения в C++26
Локальная переменная простого типа без инициализатора не получает значения по умолчанию. Если путь выполнения пропускает присваивание, программа читает мусорные данные. В них могут оказаться старые значения из стека, но рассчитывать на конкретную утечку нельзя: результат зависит от окружения и оптимизаций.
int choose_limit(bool use_default) { int limit; if (use_default) { limit = 100; } return limit; // ошибочный путь при use_default == false}В предыдущих версиях C++ чтение неопределённых значений во многих случаях приводило к UB. В C++26 приняли предложение P2795R5, вводящее категорию erroneous behavior («ошибочное поведение») для некоторых случаев чтения неинициализированных автоматических переменных. Техническую работу над C++26 комитет WG21 завершил в марте 2026 года, после чего стандарт проходит финальные этапы публикации ISO.
Изменение не делает мусорные значения допустимым стилем программирования. Код остаётся ошибочным, но компиляторы получают более подходящую модель для диагностики без прежней свободы оптимизаций в затронутых случаях. Практическое решение просто и скучно: инициализируйте переменные сразу, а отсутствие значения выражайте через специальный тип.
#include std::optional choose_limit(bool use_default) { if (use_default) { return 100; } return std::nullopt;} Гонки данных: два потока, одна переменная, никаких гарантий
Проблемы с памятью не ограничиваются указателями. Если два потока одновременно обращаются к одной неатомарной переменной, и хотя бы один поток изменяет её данные без должной синхронизации, возникает гонка данных. В C++ такая гонка приводит к UB, а не к предсказуемому «кто последний записал».
int counter = 0;void worker() { ++counter; // UB при одновременном вызове из нескольких потоков}Для простого счётчика может подойти std::atomic. Для сложных структур требуется std::mutex или архитектура, где потоки не делят изменяемое состояние. Ошибка неприятна тем, что одиночный тест почти ничего не доказывает: другой планировщик, нагрузка или процессор могут радикально изменить порядок обращений.
#include std::atomic counter{0};void worker_safe() { ++counter;} Не всякую многопоточную логику можно исправить простой заменой типа. Когда несколько полей должны изменяться согласованно, требуется защита всего инварианта. Иначе программа получит быстрые и атомарные, но логически несовместимые фрагменты состояния.
Что обнаруживают компиляторы и инструменты динамического анализа
Ручной проверки кода недостаточно. Висячая ссылка может появиться после изменения контейнера в другом месте, а переполнение размера проявиться только на повреждённом пакете. Современная сборка C++-проекта должна включать предупреждения, статический анализ и отдельные запуски под инструментами динамической проверки.
| Инструмент | Обнаруживаемые проблемы | Ограничения и стоимость |
|---|---|---|
AddressSanitizer (ASan) |
Выход за границы, использование после освобождения, двойное и некорректное освобождение, часть ошибок стека | Документация Clang указывает замедление примерно в 2 раза; значительно увеличивает расход памяти |
UndefinedBehaviorSanitizer (UBSan) |
Часть UB: знаковое переполнение, некорректные сдвиги, проблемы выравнивания, некоторые ошибочные обращения | Проверяет только выполненные пути |
MemorySanitizer (MSan) |
Чтение неинициализированных данных | Требует отдельной сборки и инструментированных зависимостей |
ThreadSanitizer (TSan) |
Гонки данных между потоками | Clang указывает замедление в 5-15 раз и рост расхода памяти в 5-10 раз |
GCC -fanalyzer, clang-tidy |
Часть путей с повторным освобождением, использованием после освобождения, проблемами интерфейсов и подозрительными конструкциями | Возможны пропуски и ложные срабатывания |
ASan и UBSan удобно запускать совместно. MSan и TSan обычно используют в отдельных конфигурациях: эти инструменты требуют сложной проверки выполнения и соответствующего набора тестов. Официальная документация Clang содержит базовые инструкции по сборке с ASan и список обнаруживаемых ошибок.
# Проверка памяти и части неопределённого поведенияclang++ -std=c++20 -O1 -g -fsanitize=address,undefined -fno-omit-frame-pointer parser.cpp -o parser_asan# Отдельная сборка для неинициализированных данныхclang++ -std=c++20 -O1 -g -fsanitize=memory -fno-omit-frame-pointer parser.cpp -o parser_msan# Отдельная сборка для гонокclang++ -std=c++20 -O1 -g -fsanitize=thread -fno-omit-frame-pointer server.cpp -o server_tsanИнструментированная сборка не доказывает безопасность программы. ASan не обнаружит выход за границы в обработчике пакетов, если тесты не передали нужный пакет. Поэтому для парсеров, декодеров, архиваторов и сетевых протоколов необходимы тесты с повреждёнными входными данными и фаззинг — автоматическая подача множества изменённых входов.
Предупреждения компилятора: ошибка должна быть заметна до запуска
Прямой возврат адреса локальной переменной, часть неинициализированных данных и очевидные проблемы владения компилятор способен обнаружить до выполнения. Но предупреждение бесполезно, если проект годами компилируется с сотнями сообщений, которые никто не читает.
Для GCC и Clang разумной отправной точкой служат строгие настройки предупреждений. Они не охватывают все ловушки и не заменяют динамическую проверку, но отсекают часть ошибок на этапе сборки.
# Clangclang++ -std=c++20 -Wall -Wextra -Wpedantic -Wconversion -Wshadow -Wreturn-stack-address source.cpp# GCCg++ -std=c++20 -Wall -Wextra -Wpedantic -Wconversion -Wshadow -Wreturn-local-addr -fanalyzer source.cppВ новом проекте предупреждения можно преобразовывать в ошибки через -Werror. В старом коде включение всех правил сразу может затопить команду в историческом шуме. Рабочий компромисс состоит в том, чтобы зафиксировать существующие проблемы, запретить новые предупреждения и постепенно очищать модули, обрабатывающие недоверенные данные.
Как модернизировать старый C++ без громких обещаний
Совет «включите ASan и замените указатели на умные» хорошо звучит в докладе, но плохо работает в крупной системе. Сетевой сервер с собственным протоколом, плагинами и десятками зависимостей не станет безопасным за вечер. Сначала команде потребуется настроить тестовое окружение, добиться воспроизводимости, выяснить, какие библиотеки можно проверить инструментами, и отделить реальные ошибки от шума стороннего кода.
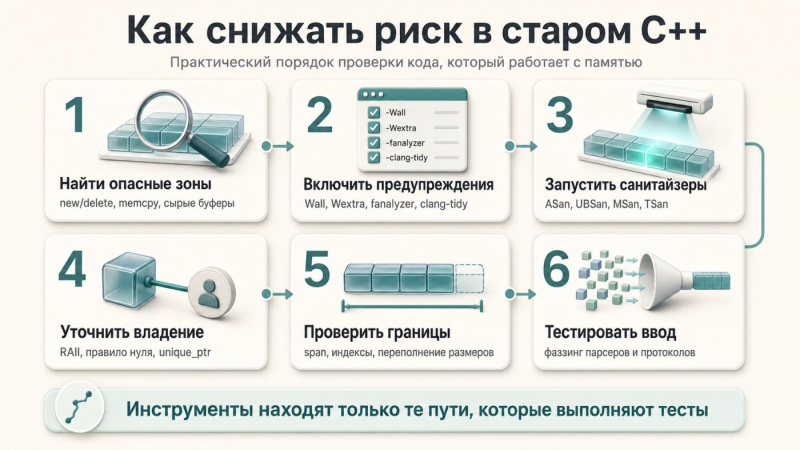
Начинать следует с границ доверия: обработчиков сетевых пакетов, форматов файлов, декодеров изображений, архиваторов, криптографических обёрток, расширений и мест, где внешние данные превращаются в длину, смещение или индекс. Утечка в локальной утилите неприятна. Переполнение в обработчике запросов представляет интерес для злоумышленника.
-
Найдите участки с
new/delete,malloc/free,memcpy, сырыми буферами, отдельно передаваемыми размерами, возвращаемыми ссылками,string_view, захватом локальных объектов по ссылке и ручными перемещающими операциями. -
Добавьте сборку с ASan и UBSan для существующих тестов, затем расширяйте покрытие опасных путей. Инструмент без тестовых сценариев не расследователь, а выключенный датчик.
-
Передавайте владение через RAII и правило нуля: используйте контейнеры, значения и
unique_ptrвместо ручного освобождения там, где позволяет архитектура. -
Модифицируйте интерфейсы диапазонов: применяйте
std::spanвместо пары «указатель-длина», добавляйте явные проверки индексов, проверяйте переполнение до арифметических операций. -
Для многопоточных компонентов запускайте TSan отдельно, а для парсеров подключите фаззинг повреждённых входов. Обычный успешный тест не выявляет гонки и не имитирует атаку.
Модернизация занимает недели и месяцы. Такая оценка звучит менее эффектно, чем обещание «безопасный C++ за выходные», зато не вводит в заблуждение ни руководителей, ни разработчиков. Ошибки памяти слишком дороги, чтобы лечить их маркетинговыми сроками.
Когда новый компонент лучше писать не на C++
C++ остаётся разумным выбором для существующих систем, двоичной совместимости, драйверов, высокопроизводительных библиотек и проектов, где значительная часть кода уже написана на этом языке. Но новый сетевой сервис, парсер недоверенных данных или компонент изоляции не обязан наследовать риски только потому, что команда привыкла к синтаксису C++.
В ноябре 2022 года АНБ США выпустило документ Software Memory Safety, рекомендующий рассматривать языки с автоматической защитой памяти. Среди примеров ведомство назвало Rust, Go, Java, C#, Swift, Ruby, Python и Ada. Для системных компонентов, требующих предсказуемой производительности без сборщика мусора, обсуждение обычно быстро сводится к Rust.
Rust не устраняет ошибки авторизации, криптографии, логические гонки и плохие протоколы. Но язык исключает целый класс проблем времени жизни и владения ещё до запуска программы. Если новый сервис принимает данные из сети и не требует совместимости с миром C++, отказ даже рассмотреть Rust выглядит не инженерным решением, а привычкой, оплачиваемой будущими инцидентами.
Вопросы и ответы
Опасности C++ легко превращаются либо в панику, либо в успокаивающее «у нас же умные указатели». Ни один из крайностей не помогает. Ниже собраны краткие ответы на вопросы, возникающие при аудите реального проекта.
Любой сырой указатель в C++ опасен?
Нет. Сырой указатель подходит для невладеющего доступа, когда объект гарантированно живёт дольше указателя. Проблема начинается, когда T* скрывает владение, выходит за время жизни объекта или используется как массив без проверенной длины. Для нового кода полезно правило: сырой указатель не владеет ресурсом.
std::unique_ptr полностью исключает использование после освобождения?
Нет. std::unique_ptr предотвращает многие ошибки ручного управления памятью, но невладеющий указатель, полученный через get(), может пережить владельца. Умный указатель управляет ресурсом, но не контролирует все ссылки на него.
std::span автоматически защищает от некорректных индексов?
В C++20 и C++23 нет. std::span объединяет указатель с размером, но обычный доступ через operator[] не обязан проверять границы. Метод at() добавлен в C++26. Индекс, пришедший извне, всё равно требует явной проверки.
Использование объекта после std::move всегда вызывает UB?
Нет. Для стандартных типов перемещённый объект обычно остаётся корректным, но его значение не определено. Объект можно уничтожить или присвоить ему новое значение. Нельзя полагаться на то, что строка после перемещения обязательно пуста или сохранила прежнее содержимое.
Достаточно ли один раз прогнать тесты под ASan?
Нет. ASan обнаруживает дефект только на выполненных путях. Если тесты не проверяют перераспределение vector, не передают избыточную длину или не воспроизводят проблемный пакет, ошибка останется скрытой. Необходимы регулярные инструментированные сборки, граничные тесты и проверка повреждёнными данными.
Нужно ли переписывать старую систему на Rust?
Полная перепись крупной C++-системы часто слишком рискованна и дорога. Разумнее изолировать самые опасные модули, усилить проверки и рассматривать языки с защитой памяти для новых компонентов, обрабатывающих недоверенные данные. Rust особенно уместен там, где нужен системный уровень и отсутствие целого класса ошибок управления памятью.
